Surveillance des logs Supabase
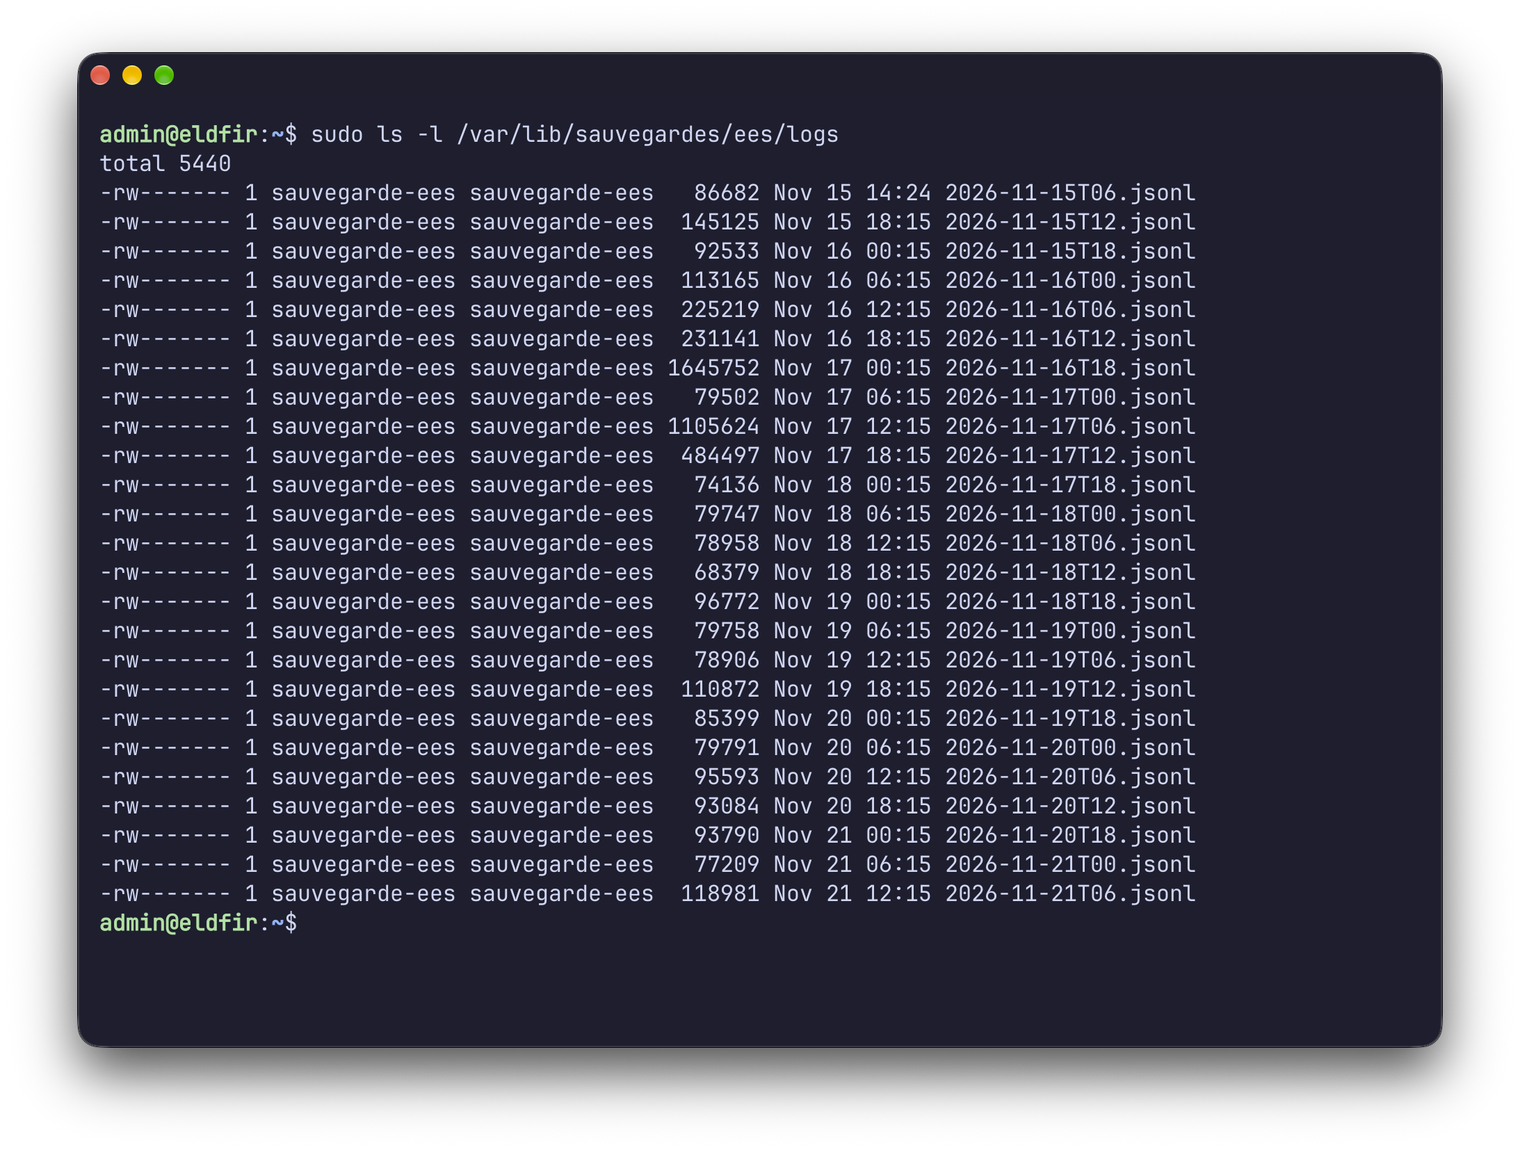 Les logs relevés sur mon VPS, un fichier par tranche de 6 heures.
Une intrusion ne se signale pas d’elle-même : il faut aller la chercher. D’après le rapport M-Trends 2026 de Mandiant, la moitié des intrusions restent plus de 14 jours sans être détectées, et dans 52 % des cas seulement, c’est l’organisation elle-même qui les découvre.
Dans cet article, je vous partage les recommandations, notamment celles de l’ANSSI, ce que j’ai mis en place pour récupérer les logs de mes projets Supabase sur mon VPS, puis comment je les analyse, avec un peu du code qui tourne réellement.
Les recommandations
Pour l’ANSSI, la journalisation est « une activité technique indispensable à la sécurité des systèmes d’information » : analyser les journaux (les logs) en continu repère les activités inhabituelles, les archiver permet de lever les doutes après coup.
Voici ce que recommandent l’ANSSI, la CNIL et l’OWASP :
- Journaliser l’essentiel : les connexions (réussies et échouées), la gestion des comptes et des droits, les accès aux données sensibles.
- Sortir les journaux de la machine qui les produit : un attaquant peut les effacer, la machine peut tomber. En temps réel si possible, sinon dans les heures qui suivent.
- Les horodater : horloges synchronisées et même fuseau horaire partout.
- Les protéger : lecture et suppression limitées au strict besoin.
- Les conserver entre six mois et un an, puis les supprimer automatiquement.
- Les exploiter : un processus d’alerte en cas d’anomalie, et la vérification que la collecte fonctionne toujours.
- Ne jamais enregistrer de mots de passe ni de jetons d’accès dans un journal, et y limiter les données personnelles.
Les textes de référence : le guide de l’ANSSI et la recommandation de la CNIL.
Les logs dans Supabase
Dans un projet Supabase, tous les services écrivent leurs logs dans une même table, logs : passerelle API, Postgres, Auth, Storage, Realtime, Edge Functions. Une colonne source indique d’où vient chaque ligne. On les consulte dans l’onglet Logs du tableau de bord.
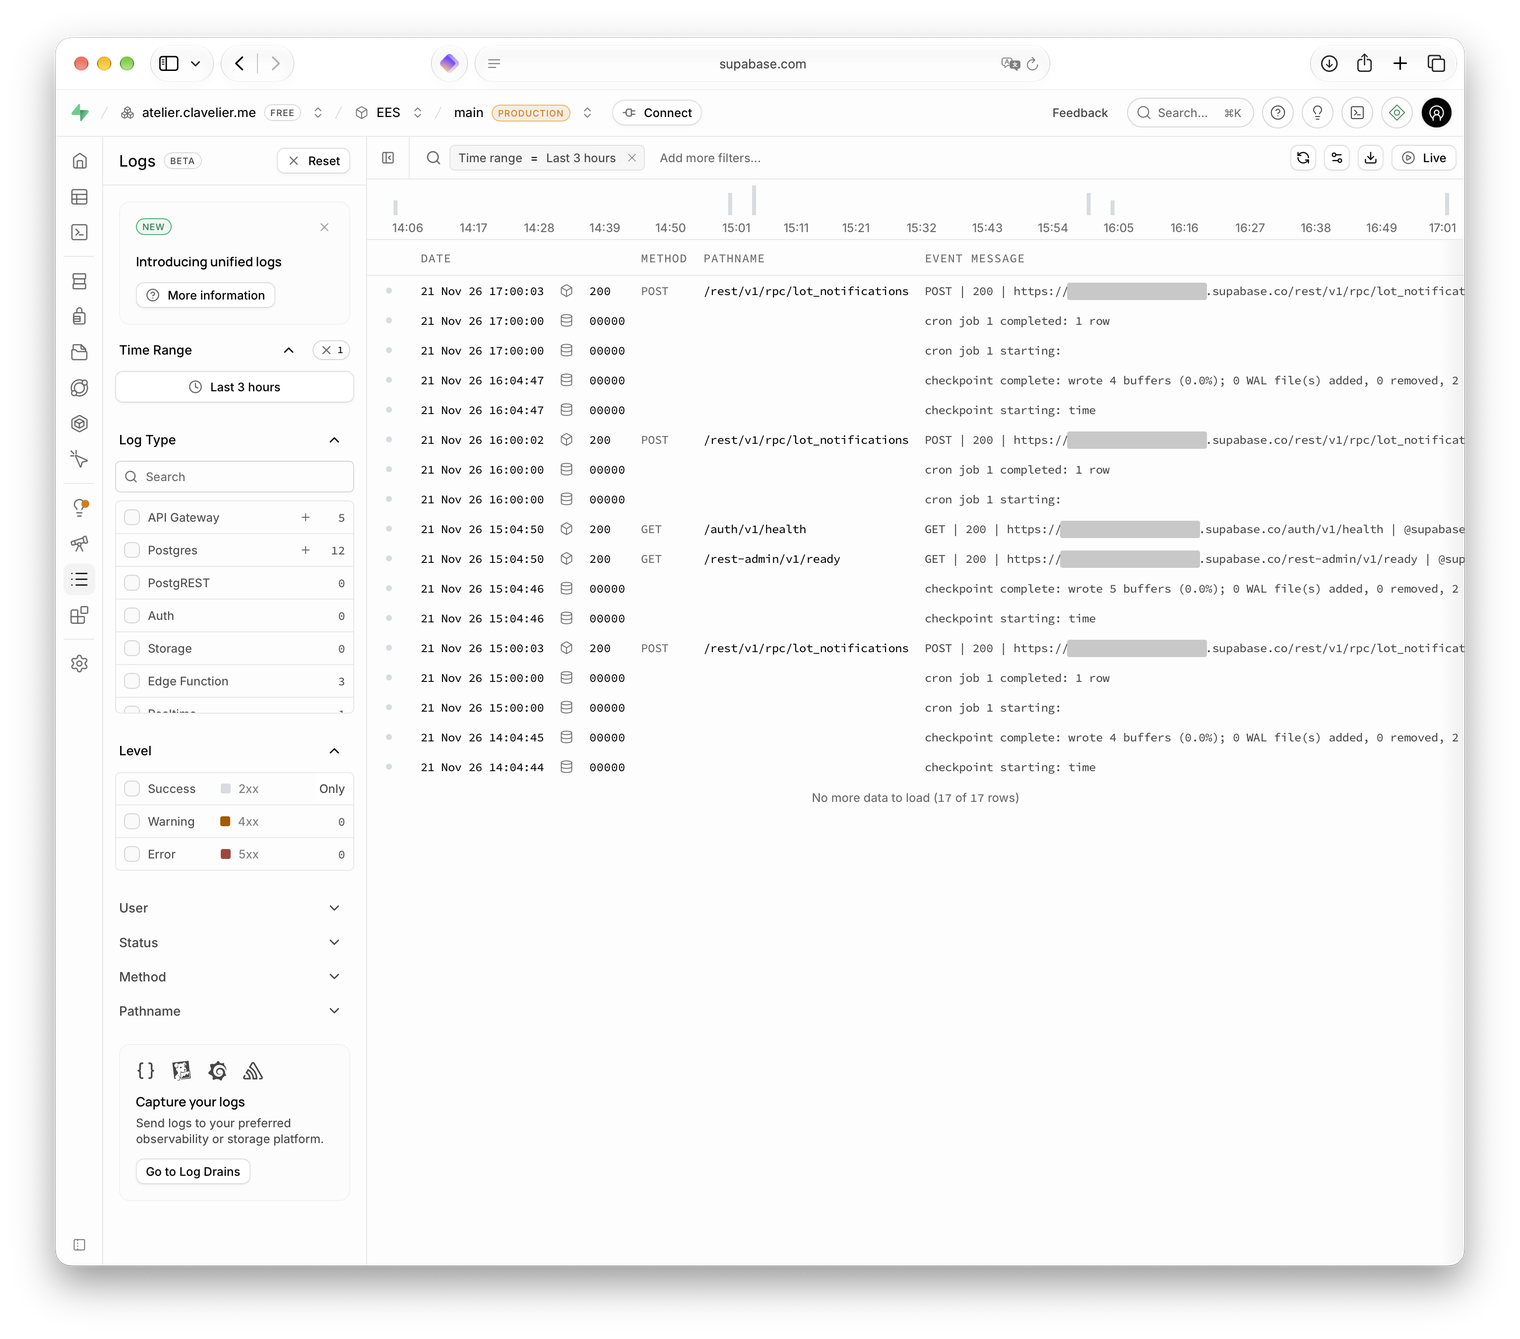 L’onglet Logs de Supabase, sur les trois dernières heures.
Ces logs ne doivent pas rester dans le projet : un attaquant peut effacer les journaux là où ils sont produits. Et Supabase ne les garde pas longtemps : 1 jour en plan Free, 7 jours en Pro, 28 en Team, 90 en Enterprise, loin des six mois à un an recommandés par la CNIL.
Deux voies existent.
Les Log Drains. Supabase pousse les logs en continu vers une destination (une plateforme d’observabilité, un stockage S3, une adresse HTTP). Réservés aux plans payants, ils sont facturés en plus de l’abonnement : 60 $ par mois et par drain, plus le volume.
L’API de gestion. On va chercher les logs soi-même, avec une requête SQL, sur une plage de 24 heures au plus. Elle fonctionne aussi en plan Free. L’accès passe par un jeton qu’on peut limiter à la seule lecture des logs : il ne peut rien modifier dans le projet.
Une précaution : interroger souvent l’API fait grossir le volume lu, que Supabase compte. Pour un flux continu, elle renvoie vers les Log Drains.
La récupération des logs
J’utilise mon VPS pour centraliser les logs de mes projets Supabase, de manière étanche : chaque projet a son utilisateur système, celui de la sauvegarde.
J’ai écrit un script commun, /usr/local/bin/supabase-logs, que chacun de ces utilisateurs peut lancer. Dans son répertoire, chaque utilisateur a l’identifiant de son projet dans un fichier de configuration, et le jeton dans un fichier que lui seul peut lire.
Toutes les 6 heures, un timer lance le script sous l’utilisateur de chaque projet. Le script relève la dernière tranche de 6 heures terminée (0-6 h, 6-12 h, 12-18 h ou 18-24 h UTC), toutes sources confondues :
T=$(( EPOCHSECONDS / 21600 * 21600 ))
DEBUT=$(date -u -d @$(( T - 21600 )) +%FT%TZ)
FIN=$(date -u -d @"$T" +%FT%TZ)
Puis il interroge l’API de gestion, page par page :
lignes=0
while :; do
  n=$(printf 'Authorization: Bearer %s\n' "$(< ~/.jeton-logs)" |
    curl -sSf --retry 5 -G "https://api.supabase.com/v1/projects/$REF/analytics/endpoints/logs" -H @- \
      --data-urlencode "sql=select timestamp, id, source, severity_text, event_message, log_attributes
        from logs order by timestamp, id limit 1000 offset $lignes" \
      --data-urlencode "iso_timestamp_start=$DEBUT" \
      --data-urlencode "iso_timestamp_end=$FIN" |
    jq -c '.result // error(.) | .[]' | tee -a "$FICHIER.part" | wc -l)
  [ "$n" -eq 0 ] && break
  lignes=$(( lignes + n ))
donelignes compte les logs déjà relevés : zéro au départ. while : veut dire « tant que vrai » : la boucle tourne jusqu’à ce que break l’arrête.
À chaque tour, un tube. Chaque | passe la sortie d’une commande à la suivante :
printfécrit la ligne d’authentification, avec le jeton lu dans~/.jeton-logs.curllit cette ligne sur son entrée (-H @-), ce qui garde le jeton hors de la liste des processus, et envoie à l’API la requête SQL et les bornes de la tranche. Il reçoit au plus 1000 logs, à partir du numéro$lignes. Il retente jusqu’à 5 fois une erreur passagère (--retry 5) et échoue si l’API répond par une erreur (-f).jqextrait la liste des logs de la réponse et écrit un log par ligne. Si la requête a échoué, la réponse n’a pas de liste :jqéchoue, et le relevé avec.teeajoute ces lignes au fichier de la tranche et les transmet à la suite.wc -lles compte.
Le compte est rangé dans n. S’il vaut zéro, tout est relevé : break sort de la boucle. Sinon, lignes augmente de n, et le tour suivant demande les 1000 logs d’après.
Le résultat est enregistré dans le dossier logs de l’utilisateur : un fichier par tranche, nommé par son début (2026-11-17T12.jsonl), une ligne par log. L’ANSSI demande que les journaux quittent la machine qui les produit au plus tard quelques heures après leur génération : on reste dans ce cadre.
Le script n’a le droit d’écrire que dans ce dossier. Les fichiers de plus d’un an sont supprimés à chaque passage, le haut de la fourchette de la CNIL :
find ~/logs -name '*.jsonl' -mtime +365 -deleteComme pour la sauvegarde, le timer et le service sont des modèles systemd, communs à tous les projets, où %i prend le nom du projet. En voici l’essentiel :
# supabase-logs@.timer
[Timer]
OnCalendar=*-*-* 00/6:15:00
Persistent=true

# supabase-logs@.service
[Service]
Type=oneshot
User=sauvegarde-%i
ExecStart=/usr/local/bin/supabase-logs
ReadWritePaths=/var/lib/sauvegardes/%i/logs
Une limite acceptée : au redémarrage du serveur, le relevé manqué est relancé (Persistent=true), mais il ne prend que la dernière tranche terminée. Une tranche plus ancienne restée sans relevé est perdue.
L’analyse des logs
Archiver ne suffit pas : pour repérer une intrusion, il faut lire les logs. La CNIL recommande une analyse en temps réel ou à court terme, avec un processus d’alerte formalisé.
Supabase propose des contrôles de départ : le nombre de réponses 5xx (erreurs du serveur) et de réponses 401 et 403 (accès refusés), heure par heure, à comparer à l’activité habituelle. La documentation précise qu’un pic est un signal à examiner, pas la preuve d’une attaque.
Voici ce que j’ai mis en place, en trois étages.
Un tableau de chiffres
Chaque nuit, un script lit les logs relevés sur mon VPS et en tire un tableau des sept derniers jours, un jour par ligne :
- les tranches de 6 heures relevées (4 attendues) ;
- le nombre de lignes de log ;
- les connexions refusées pour identifiants erronés ;
- les réponses 401 et 403 ;
- les réponses 5xx ;
- les lignes graves (avertissements, erreurs, erreurs fatales).
Le script, /usr/local/bin/supabase-analyse, est lui aussi commun à tous les projets :
shopt -s nullglob

{
  printf 'jour\ttranches\tlignes\tmdp_errones\t401_403\t5xx\tgraves\n'
  for i in {1..7}; do
    JOUR=$(date -u -d "$i day ago" +%F)
    FICHIERS=(~/logs/"$JOUR"T*.jsonl)
    jq -rs --arg jour "$JOUR" --arg tranches "${#FICHIERS[@]}" '
      def nombre(f): map(select(f)) | length;
      def http: .log_attributes["response.status_code"] | tostring;
      [$jour, $tranches, length,
       nombre(.log_attributes.error_code == "invalid_credentials"),
       nombre(http | test("^40[13]$")),
       nombre(http | startswith("5")),
       nombre(.severity_text | IN("WARNING", "ERROR", "FATAL", "PANIC"))] | @tsv' /dev/null "${FICHIERS[@]}"
  done
} | column -tTout ce qui s’écrit entre les accolades part dans un seul tube, vers column -t :
printfécrit l’en-tête du tableau.forrépète la suite pour chacun des sept derniers jours, dontdatedonne la date.FICHIERSliste les fichiers du jour : un par tranche, donc leur nombre est celui des tranches relevées. Avecshopt -s nullglob, un jour sans fichier donne une liste vide.jqlit tous les fichiers du jour d’un coup (-s) et compte les logs de chaque colonne du tableau. Il écrit la ligne du jour./dev/nulllui donne toujours un fichier à lire, même un jour sans relevé : tout est alors à zéro.column -taligne l’en-tête et les sept lignes en colonnes.
Le script affiche son tableau à l’écran, mais il tourne la nuit, lancé par un timer : personne n’est là pour le voir. Tout ce qu’affiche un service lancé par systemd est repris dans le journal du système. Le service d’analyse y range son tableau sous une étiquette (SyslogIdentifier=supabase-analyse), et c’est là qu’on le retrouve, comme le mail du matin :
journalctl -t supabase-analyseLe tableau ne contient que des chiffres : aucune ligne de log n’est recopiée, donc aucune donnée personnelle. Le script tourne sous l’utilisateur du projet, sans accès au réseau (PrivateNetwork=yes dans son service).
Voici celui du 21 novembre pour mon espace d’échanges sécurisés :
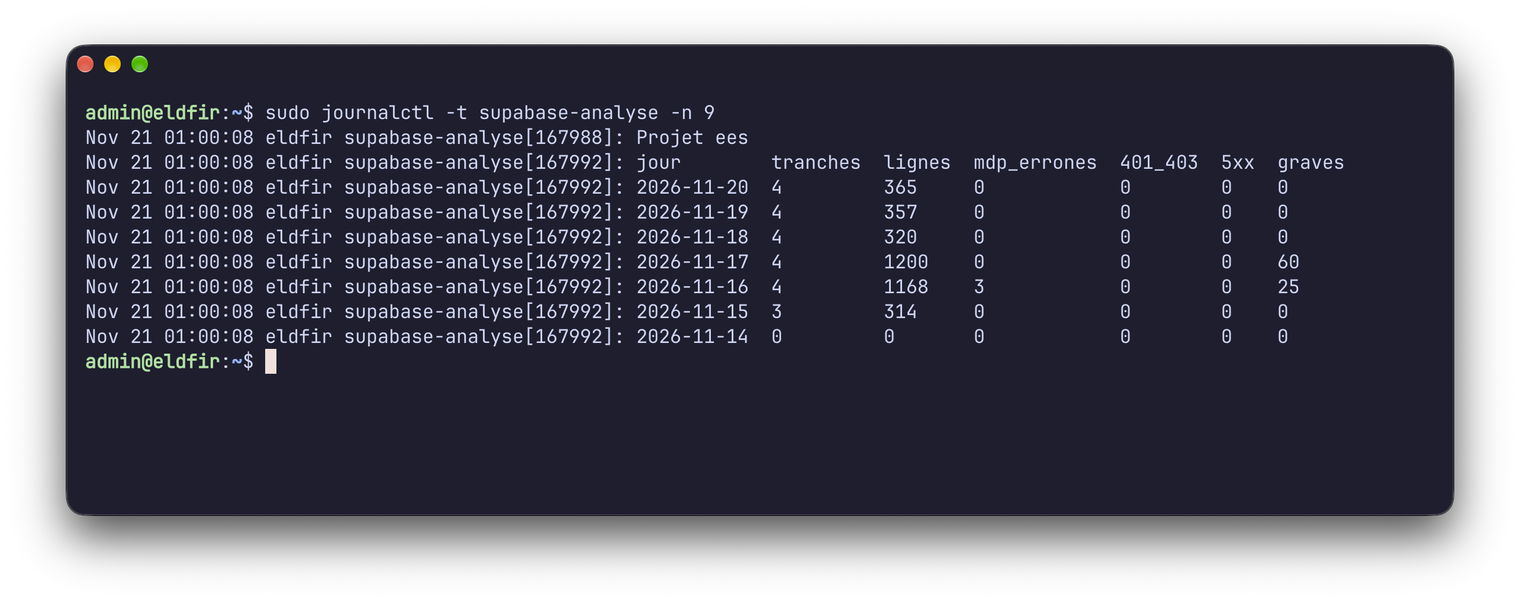 Le tableau du 21 novembre, retrouvé dans le journal du système.
La colonne des tranches vérifie la collecte elle-même : un jour à 3 au lieu de 4, et je sais qu’un relevé a manqué. L’ANSSI demande de contrôler régulièrement que la chaîne de collecte fonctionne. Ici, le relevé a été mis en service le 15 novembre : rien avant, et la première tranche de ce jour-là n’a pas été relevée.
Un mail chaque matin
Le tableau rejoint le mail de surveillance quotidien de mon VPS, celui qui me signale déjà les mises à jour à faire. Ce mail part même quand tout va bien : s’il n’arrive pas, c’est que quelque chose est cassé.
Un second regard
Je lis le mail chaque matin. Au moins une fois par semaine, ou dès qu’un chiffre m’inquiète, je le donne aussi à Claude Code, avec un skill que j’ai écrit, pour vérifier que rien ne m’a échappé. L’agent classe chaque chiffre : sain, bruit déjà connu, ou à regarder. Son verdict tient en quelques lignes, datées, dans un fichier par mois. Chaque cause bénigne confirmée rejoint la liste du bruit connu.
Le 18 novembre, le tableau affichait 60 lignes graves pour la veille : mes tests de sécurité et le redémarrage de Postgres pendant une mise à jour du projet. Sur ce tableau, l’agent ne m’a rien appris. Mais il a bouclé : chaque chiffre a son explication, et aucune tranche ne manque.
Les limites, à ce jour :
- Pas d’alerte en temps réel : une anomalie se voit au mieux le lendemain matin.
- Pas de seuil automatique : c’est ma lecture quotidienne qui fait l’alerte.
- Un seul projet suivi pour l’instant.
Ajout d’un nouveau projet
Concrètement, pour relever les logs d’un nouveau projet, je crée dans Supabase un jeton en lecture seule des logs. Le reste se fait sur le VPS, pour l’utilisateur du projet, qui existe déjà pour la sauvegarde :
sudo install -d -m 700 -o sauvegarde-<projet> -g sauvegarde-<projet> /var/lib/sauvegardes/<projet>/logs
echo 'REF="<ref>"' | sudo tee -a /var/lib/sauvegardes/<projet>/config > /dev/null
sudo -u sauvegarde-<projet> sh -c 'umask 077; cat > ~/.jeton-logs'
sudo systemctl start supabase-logs@<projet>.service
sudo systemctl enable --now supabase-logs@<projet>.timer supabase-analyse@<projet>.timerinstall -dcrée le dossierlogs, qui appartient à l’utilisateur du projet (-o,-g) et n’est accessible qu’à lui (-m 700).echo … | sudo tee -aajoute la ligneREF="<ref>"à la fin du fichier de configuration, sans l’écraser (-a).> /dev/nullévite queteela réaffiche à l’écran.sudo -ulance une commande sous l’utilisateur du projet.cat > ~/.jeton-logsattend le jeton : on le colle, Entrée, puis Ctrl-D.umask 077rend le fichier lisible par cet utilisateur seul. Le jeton n’est pas tapé dans la commande : il ne reste ni dans l’historique ni dans la liste des processus.systemctl startlance un premier relevé tout de suite, sans attendre le timer, pour vérifier que tout fonctionne.supabase-logs@<projet>est le modèle commun, appliqué à ce projet.systemctl enable --nowactive les deux timers :enableles relance à chaque démarrage du VPS,--nowles démarre sans attendre.
Conclusion
La première chose que je retiens, c’est qu’on ne trouve pas d’intrusion ou de piratage si on ne regarde pas. La moitié des intrusions restent plus de 14 jours sans être détectées. Les logs gardent la trace de ce qui se passe sur un projet, encore faut-il aller les lire.
Les recommandations de l’ANSSI et de la CNIL vont dans ce sens : sortir les logs de l’application dans les quelques heures qui suivent, parce qu’un attaquant peut les effacer là où ils sont produits ; les conserver entre six mois et un an, quand Supabase ne les garde qu’un jour en plan Free et sept en Pro ; et les analyser rapidement.
Une bonne partie de ce travail peut s’automatiser. Chez moi, la collecte et le tableau de chiffres tournent seuls, et un mail me l’envoie chaque matin, même quand tout va bien : s’il n’arrive pas, je sais que quelque chose est cassé.
Concernant l’analyse des journaux, les LLM sont un atout. Relire rapidement des centaines de lignes, c’est exactement ce qu’ils font bien. Au moins une fois par semaine, ou dès qu’un chiffre m’inquiète, je donne le mail à Claude Code, qui classe chaque chiffre : sain, bruit déjà connu, ou à regarder. Je m’en sers comme d’un second regard, pas comme d’un remplaçant.
Tout cela demande du temps et de l’organisation. J’ai centralisé le suivi des logs de mes projets Supabase sur mon VPS, un utilisateur système par projet. Chaque outil ajouté demande sa part d’attention, comme pour les mises à jour, et le VPS a lui-même ses propres journaux à examiner. C’est un vrai travail de surveillance.