Sauvegarder un projet Supabase
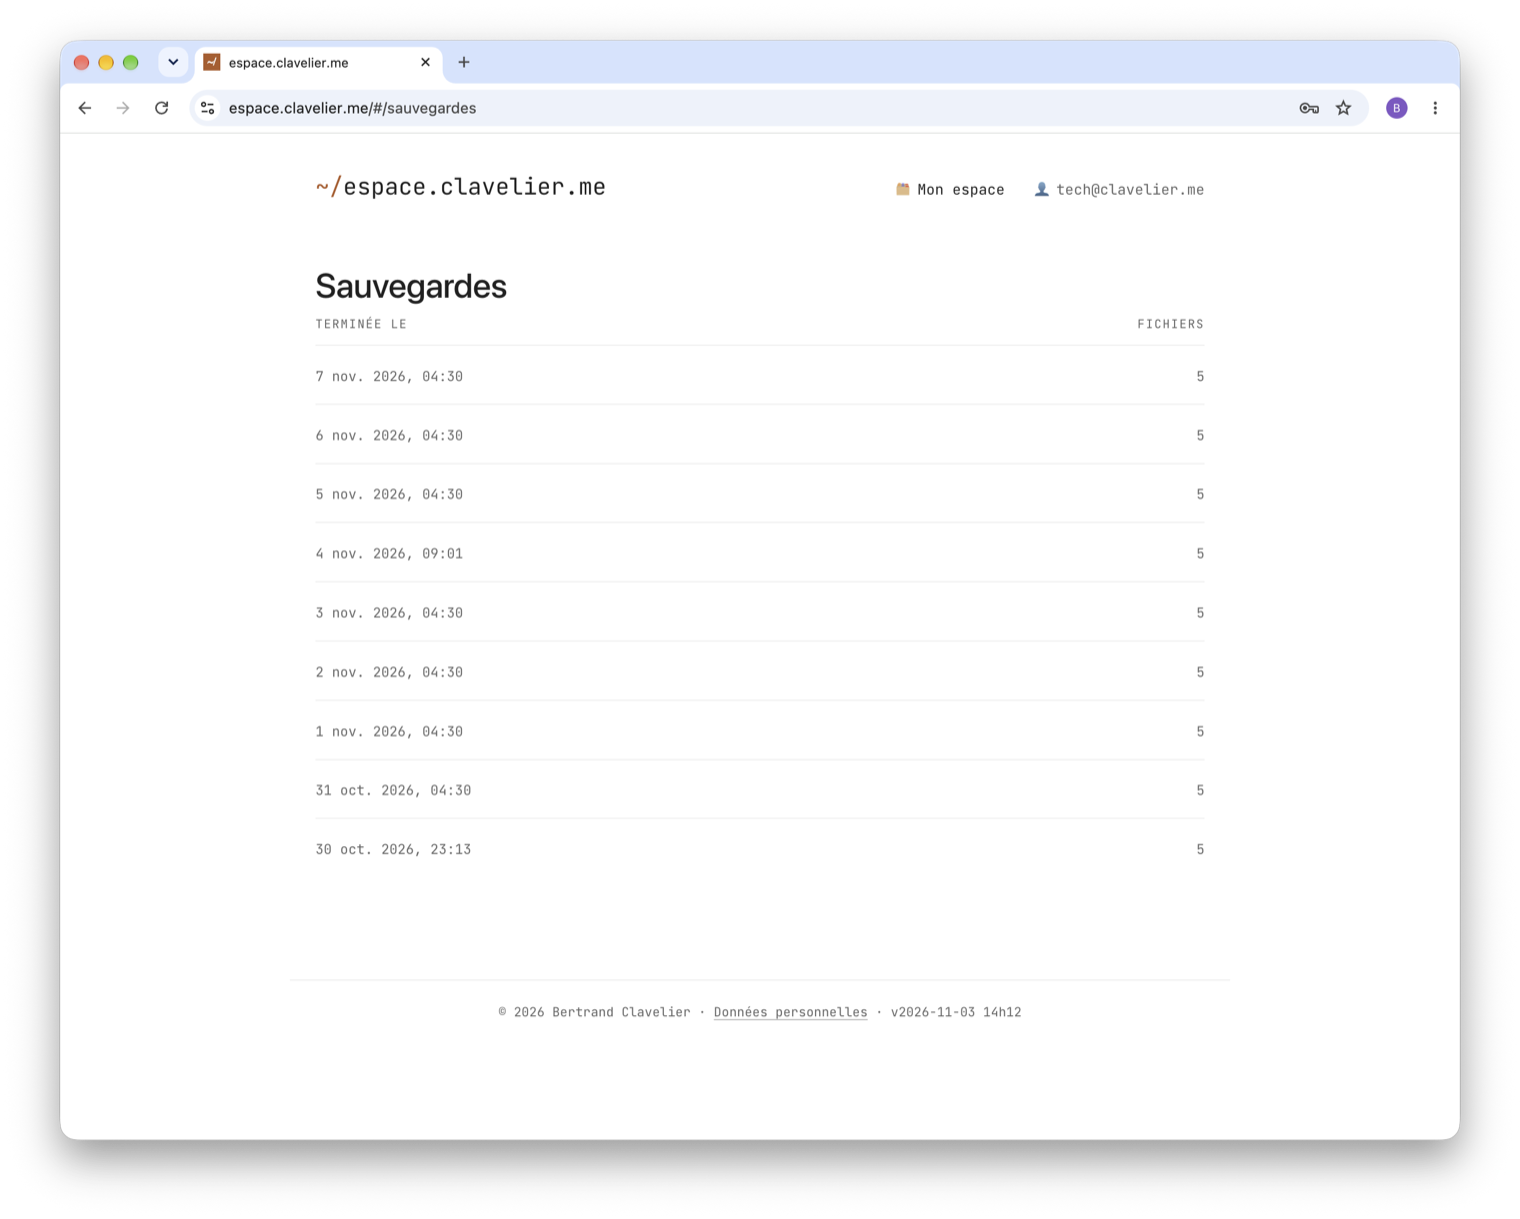 Le journal des sauvegardes, vu depuis l’espace.
Dans sa version Pro, Supabase propose un système de sauvegarde sur 7 jours glissants, qui permet de revenir à une sauvegarde antérieure en cas de problème ou d’erreur. Mais pour un projet en production, cela ne me semble pas suffisant : s’il y avait un crash chez Supabase, tout serait perdu, et ce ne serait évidemment pas satisfaisant.
Il faut donc une sauvegarde extérieure.
Dans cet article, je vous partage comment j’ai mis en place la sauvegarde de mon espace d’échanges sécurisés à partir de mon VPS, avec un peu du code qui tourne réellement.
Préalable
Voici le cadrage que je me suis donné. Je veux :
- une sauvegarde quotidienne automatique ;
- une sauvegarde qui permette une restauration complète dans un projet vierge ;
- un protocole unique pour sauvegarder différents projets sur mon VPS ;
- l’étanchéité des différentes sauvegardes ;
- le chiffrement des sauvegardes.
Quoi sauvegarder
Il s’agit d’abord de cibler ce qu’il faut sauvegarder pour restaurer l’ensemble du projet, de manière fonctionnelle, à partir d’un projet Supabase vierge. Je distingue trois points.
La structure du projet. Ce sont les schémas propres au projet (public et prive pour mon espace), et non ceux que Supabase installe pour son fonctionnement. On y retrouve bien évidemment les tables, les fonctions et les règles d’accès qui protègent les données (GRANT, RLS…).
Les données elles-mêmes, que je sépare en deux : d’un côté le contenu des tables et les comptes utilisateurs avec leurs mots de passe, de l’autre les fichiers déposés dans le Storage. Dit autrement, les données à sauvegarder sont à deux endroits différents. La documentation de Supabase le précise : une sauvegarde de la base ne contient pas les fichiers du Storage, seulement leurs métadonnées.
La configuration de l’authentification et du projet en général (restrictions réseau…), ainsi que les Edge Functions. Cela fait bien entendu partie du projet, de son bon fonctionnement et de sa sécurité. Mais tout cela n’est ni dans la base ni dans le Storage : c’est écrit dans la documentation du projet, et c’est à partir d’elle qu’on le remet en place.
Quel outil utiliser ?
J’utilise mon VPS, qui héberge les sauvegardes (et qui est lui-même sauvegardé), et je décide de faire un script.
Le téléchargement repose sur deux outils : pg_dump récupère la base, structure et données, et rclone récupère tous les fichiers du Storage, que Supabase rend accessible par le protocole S3.
pg_dump "$CONNEXION" -Fc --strict-names $SCHEMAS -n auth -n storage -n supabase_migrations -f /tmp/base.dump
rclone copy supabase: /tmp/stockage
$CONNEXION et $SCHEMAS viennent de la configuration du projet, présentée plus bas. Le script y ajoute trois schémas : auth pour les comptes, storage pour les buckets et leurs règles d’accès, supabase_migrations pour l’historique des migrations. Le format custom (-Fc) permettra de choisir à la restauration ce qu’on rejoue, et avec --strict-names, un schéma introuvable est une erreur et non un oubli silencieux. Enfin, pg_dump ne sait pas lire un serveur plus récent que lui : le client PostgreSQL du VPS doit être d’une version au moins égale à celle de la base Supabase.
Toutes ces données arrivent en clair dans un dossier temporaire du serveur.
J’utilise ensuite restic pour les chiffrer (en AES-256) et les ranger dans un dépôt, une version par nuit. Il permet de gérer les versions comme on le souhaite : je garde une sauvegarde par jour sur 30 jours et une par mois sur un an.
restic backup /tmp/base.dump /tmp/stockage
restic forget --prune --keep-daily 30 --keep-monthly 12
restic check --read-data
D’une version à l’autre, restic n’enregistre que ce qui a changé : un fichier du Storage déjà présent dans le dépôt n’y est pas stocké une seconde fois. La dernière commande relit tout le dépôt à chaque passage : une corruption se voit le lendemain, pas le jour où l’on a besoin de la sauvegarde.
Ce fonctionnement est taillé pour un projet de petite taille : chaque nuit, le Storage est retéléchargé en entier et le dépôt relu en entier. Pour de gros volumes, il faudrait ne télécharger que les fichiers nouveaux, et ne relire qu’une partie du dépôt à chaque passage (--read-data-subset).
Une fois les données chiffrées et rangées dans le dépôt, les données temporaires en clair sont supprimées.
Quel protocole j’ai mis en place
Je souhaite un protocole qui permette de sauvegarder facilement n’importe quel projet sur mon VPS. Je crée donc un script général, /usr/local/bin/sauvegarde-supabase, qui lit les spécificités du projet dans un fichier de configuration. Ce fichier contient deux choses : l’identifiant du projet Supabase et les schémas à sauvegarder.
CONNEXION="host=db.<identifiant>.supabase.co port=5432 dbname=postgres user=postgres sslmode=verify-full sslrootcert=/var/lib/sauvegardes/ees/prod-ca-2021.crt"
SCHEMAS="-n public -n prive"
Avec sslmode=verify-full, le mode que recommande Supabase, la connexion est chiffrée et le serveur authentifié par le certificat racine de Supabase, à télécharger dans les réglages de la base, où j’impose aussi SSL à toute connexion. À noter : la connexion directe à db.<identifiant>.supabase.co se fait en IPv6, sauf option IPv4 ; le VPS doit donc avoir une adresse IPv6.
Pour assurer l’étanchéité des sauvegardes, chaque projet a son utilisateur système. Pour mon espace, c’est sauvegarde-ees, un compte de service sans session ni mot de passe. Son répertoire personnel, /var/lib/sauvegardes/ees, n’est accessible qu’à lui (droits 700). Il contient le fichier de configuration et les trois secrets : le mot de passe de Postgres, la clé S3 du Storage et le mot de passe du dépôt restic.
/var/lib/sauvegardes/ees/
├── config                       la configuration du projet
├── prod-ca-2021.crt             le certificat racine de Supabase
├── .pgpass                      le mot de passe de Postgres
├── .config/rclone/rclone.conf   la clé S3 du Storage
├── .restic-password             le mot de passe du dépôt
└── depot/                       le dépôt restic chiffré
Dossiers en 700, fichiers en 600 : PostgreSQL ignore d’ailleurs un .pgpass lisible par d’autres que son propriétaire. Le script, lui, appartient à root : chaque utilisateur l’exécute sans pouvoir le modifier.
Deux de ces secrets sont particulièrement sensibles : le mot de passe de Postgres donne tous les droits sur la base, et la clé S3, qui contourne les règles RLS, tous les droits sur le Storage. Les trois doivent être gardés ailleurs, surtout celui de restic : sans lui, les données seraient indéchiffrables. Ils sont donc aussi dans mon gestionnaire de mots de passe.
Je décide également d’imposer à Supabase de n’accepter les connexions à la base que depuis les adresses IPv4 et IPv6 de mon VPS. Ainsi, même avec le mot de passe Postgres, impossible de se connecter à ma base depuis une autre IP. Ces restrictions réseau portent sur Postgres : elles ne couvrent ni l’API ni le Storage. La clé S3, elle, fonctionne depuis n’importe où : elle ne doit jamais quitter le serveur.
Le script étant finalisé, il ne reste qu’à programmer un timer système qui le lance sous l’utilisateur associé à la sauvegarde. Le timer et le service sont eux aussi communs à tous les projets : ce sont des modèles systemd, sauvegarde@.timer et sauvegarde@.service, où %i prend le nom du projet. En voici l’essentiel :
# sauvegarde@.timer
[Timer]
OnCalendar=03:30
Persistent=true

# sauvegarde@.service
[Service]
Type=oneshot
User=sauvegarde-%i
ExecStart=/usr/local/bin/sauvegarde-supabase
PrivateTmp=yes
ProtectSystem=strict
ReadWritePaths=/var/lib/sauvegardes/%i
ProtectHome=yes
NoNewPrivileges=yes
Ainsi, sauvegarde@ees.timer lance chaque nuit à 3 h 30 UTC le script commun sous sauvegarde-ees.
Par rapport à une ligne de cron, systemd apporte trois avantages. Persistent=true rattrape un passage manqué si la machine était éteinte à l’heure dite. Tout ce que le script écrit se retrouve dans le journal, avec journalctl -u sauvegarde@ees.service. Enfin, le service est enfermé : le système est en lecture seule sauf le dossier du projet (ProtectSystem, ReadWritePaths), /home est invisible (ProtectHome), et aucune élévation de privilèges n’est possible (NoNewPrivileges). PrivateTmp lui donne un /tmp que les autres comptes ne voient pas et qui est vidé à la fin : c’est lui qui fait disparaître les données en clair. Et sur Debian 13, /tmp est en mémoire vive : les données en clair n’y passent pas par le disque.
Suivi des sauvegardes
Chaque projet sauvegardé comporte une table sauvegardes, où le script inscrit, par sa dernière commande, la date et l’heure de chaque sauvegarde complète :
psql "$CONNEXION" -c "insert into prive.sauvegardes (passage, nb_fichiers) values ('$(date -u +%Y%m%dT%H%M%SZ)', $(find /tmp/stockage -type f | wc -l))"Le script commence par set -euo pipefail, qui l’arrête à la première erreur : un passage qui échoue n’écrit rien. On a ainsi dans une table la liste des sauvegardes réussies.
Cela permet à pg_cron (présenté dans Supabase avancé) de vérifier chaque matin à 7 h UTC que la dernière sauvegarde a bien été faite. Si elle a plus de 26 heures, une Edge Function m’envoie un mail. Je l’ai testé : le timer coupé le 3 novembre, le mail est arrivé le 4 au matin.
Ajout d’un nouveau projet à sauvegarder
Concrètement, pour sauvegarder un nouveau projet :
- je crée un nouvel utilisateur système associé à la sauvegarde ;
- je dépose le fichier de configuration et les trois secrets dans son répertoire personnel ;
- j’initialise le dépôt ;
- j’active le timer ;
- j’ajoute la table de suivi dans le projet.
Côté VPS, voici les commandes des étapes 1, 3 et 4 :
sudo useradd --system --no-create-home --home-dir /var/lib/sauvegardes/<projet> --shell /usr/sbin/nologin sauvegarde-<projet>
sudo install -d -m 700 -o sauvegarde-<projet> -g sauvegarde-<projet> /var/lib/sauvegardes/<projet>

sudo -u sauvegarde-<projet> restic -r /var/lib/sauvegardes/<projet>/depot --password-file /var/lib/sauvegardes/<projet>/.restic-password init

sudo systemctl enable --now sauvegarde@<projet>.timer
Reste à limiter l’accès à la base à mon VPS, dans les réglages du projet, et à lancer un premier passage à la main pour tout vérifier sans attendre la nuit : sudo systemctl start sauvegarde@<projet>.service.
Restauration
Maintenant que le système de sauvegarde est en place et se lance toutes les nuits pour mon espace d’échanges sécurisés, il me reste à faire le chemin inverse pour m’assurer de sa fiabilité. Il n’y a pas cinquante solutions : repartir d’un projet Supabase vierge et le reconstruire à l’identique.
Cette fois, pas de script (ce serait possible), mais un simple protocole documenté. En préalable, il faut avoir sous la main le mot de passe Postgres de la nouvelle base et la clé S3 du Storage du nouveau projet.
- Sur le VPS, ouverture d’un shell sous l’utilisateur système du projet sauvegardé, qui n’a pas de session propre (
sudo -u sauvegarde-<projet> bash). - Saisie des secrets du nouveau projet avec
read, assignés à des variables qui ne vivent qu’en mémoire. - Déchiffrement de la dernière sauvegarde dans un dossier temporaire avec
restic restore. - Liste de ce qui va être restauré dans Postgres, sans les structures qu’un projet Supabase vierge contient déjà.
- Restauration de cette liste avec
pg_restore. - Copie des fichiers dans le Storage avec
rclone copy. - Vérification : le nombre de lignes de chaque table est comparé à celui de la base d’origine quand elle existe encore, les fichiers du Storage à ceux de la sauvegarde, puis les tests de sécurité sont rejoués sur la nouvelle base.
- Le ménage : le dossier temporaire est supprimé.
Les étapes 4 et 5 sont les plus délicates. Le dump contient les schémas auth et storage, qu’un projet vierge possède déjà : on n’en rejoue que les données, ainsi que les triggers et les règles d’accès propres au projet. Les lignes de storage.objects ne sont pas rejouées : l’envoi des fichiers par rclone les recrée. pg_restore -l sort le sommaire du dump, un filtre awk en retire le reste, et le fichier liste obtenu dit à pg_restore quoi rejouer. La commande, abrégée :
pg_restore -L liste -f - tmp/base.dump | psql "$CIBLE" --single-transaction -v ON_ERROR_STOP=1 \
  -c 'alter default privileges for role postgres in schema public revoke all on tables from anon, authenticated' \
  -c 'set session_replication_role = replica' \
  -f -
Trois choses à y voir. --single-transaction : tout passe ou rien n’est écrit. Les alter default privileges : un projet Supabase ouvrait d’office ses nouvelles tables à anon et authenticated (ce n’est plus le cas par défaut depuis 2026), et PostgreSQL ouvre l’exécution des fonctions à tous. Le dump ne retirant aucun droit, ces lignes garantissent que la nouvelle base ne sera pas plus ouverte que l’ancienne, quel que soit le réglage du projet. Le mode replica, enfin, suspend les triggers, et avec eux le contrôle des clés étrangères, le temps du chargement : les tables de auth sont chargées dans l’ordre alphabétique, alors que leurs clés étrangères existent déjà. Le guide de restauration de Supabase procède de la même façon.
J’ai joué ce protocole le 2 novembre 2026 dans un projet de test, supprimé ensuite. Résultat : le même nombre de lignes dans chaque table (hors le passage inscrit après la sauvegarde restaurée), 5 fichiers conformes à l’empreinte SHA-256 enregistrée à leur dépôt et 252 tests de sécurité sans écart.
Ce protocole n’est pas complet : le dump ne contient que les schémas choisis, sans les extensions dont ils dépendent. À partir de la documentation, il faut encore paramétrer dans le nouveau projet pg_net, pg_cron, les Edge Functions et leurs secrets, l’authentification (URL, SMTP, modèles de mails), puis reconfigurer les secrets de la sauvegarde.
Il faut compter environ 30 minutes pour la restauration, auxquelles s’ajoute le paramétrage du nouveau projet.
Conclusion
La sauvegarde d’un projet numérique, quel qu’il soit, est un sujet important à prendre en compte dès le début. Savoir comment sauvegarder un projet Supabase quelconque et avoir un protocole pour le faire facilement est pour moi essentiel.
Il est également important de faire en sorte que tout soit chiffré et bien étanche : la sauvegarde corrompue d’un projet ne corrompt pas celles des autres.
La sauvegarde se fonde sur la sécurité de Debian, les utilisateurs Unix avec leurs droits, la gestion du chiffrement avec restic, PostgreSQL avec pg_dump et pg_restore, et le Storage avec rclone.
Une sauvegarde ne peut être considérée comme fiable qu’une fois sa restauration testée en réel : pour être sûr du protocole, et pour avoir, le jour d’un vrai sinistre, les bonnes commandes dans le bon ordre.
L’ajout d’un nouveau projet Supabase à sauvegarder est pour moi très simple et se fait en quelques commandes sur mon VPS.
La documentation, enfin, est un pilier fondamental, pour savoir quoi faire en cas de sinistre.
Tout ce travail fait partie d’un projet bien tenu.